Kimi、最も高性能な3T-classオープンウェイトモデル「Kimi K3.1 Pro」を発表
Kimiは、「Kimi K3.1 Pro」と高速版の「Kimi K3.1 Pro Highspeed」を発表した。両モデルはKimi.ai、Kimi Work、Kimi Code、Kimi APIで利用でき、完全なモデルウェイトは今後公開される予定である。
Kimi K3.1 Pro は、Kimiの新しいK3.1シリーズの最初のモデルである。同社はこれを、これまでに公開したモデルの中で最も高性能な3T-classオープンウェイトモデルと位置づけている。コンテキストウィンドウは1-million-tokenである。
発表内容と提供状況
Kimi K3.1 Pro は、Kimi K3 を事後学習したモデルであり、事後学習の計算量は大幅に増やされている。同時に公開された Kimi K3.1 Pro Highspeed について、Kimiは K3.1 Pro の2-3×の速度を実現すると述べている。
両モデルは現在、以下の環境で利用できる。
- Kimi.ai およびKimiモバイルアプリ
- Kimi Work および Kimi Code
- Kimi API(Zero Data Retention も利用可能)
Kimi Enterprise の管理者は、組織向けに K3.1 Pro を有効にできる。導入時点では初期設定でオフになっている。Kimi Work のデスクトップアプリは、バージョン3.1.0以降がWindowsおよびApple silicon Mac向けに提供される。また、3D Make が kimi.ai と Kimiアプリで公開された。
ベンチマーク結果
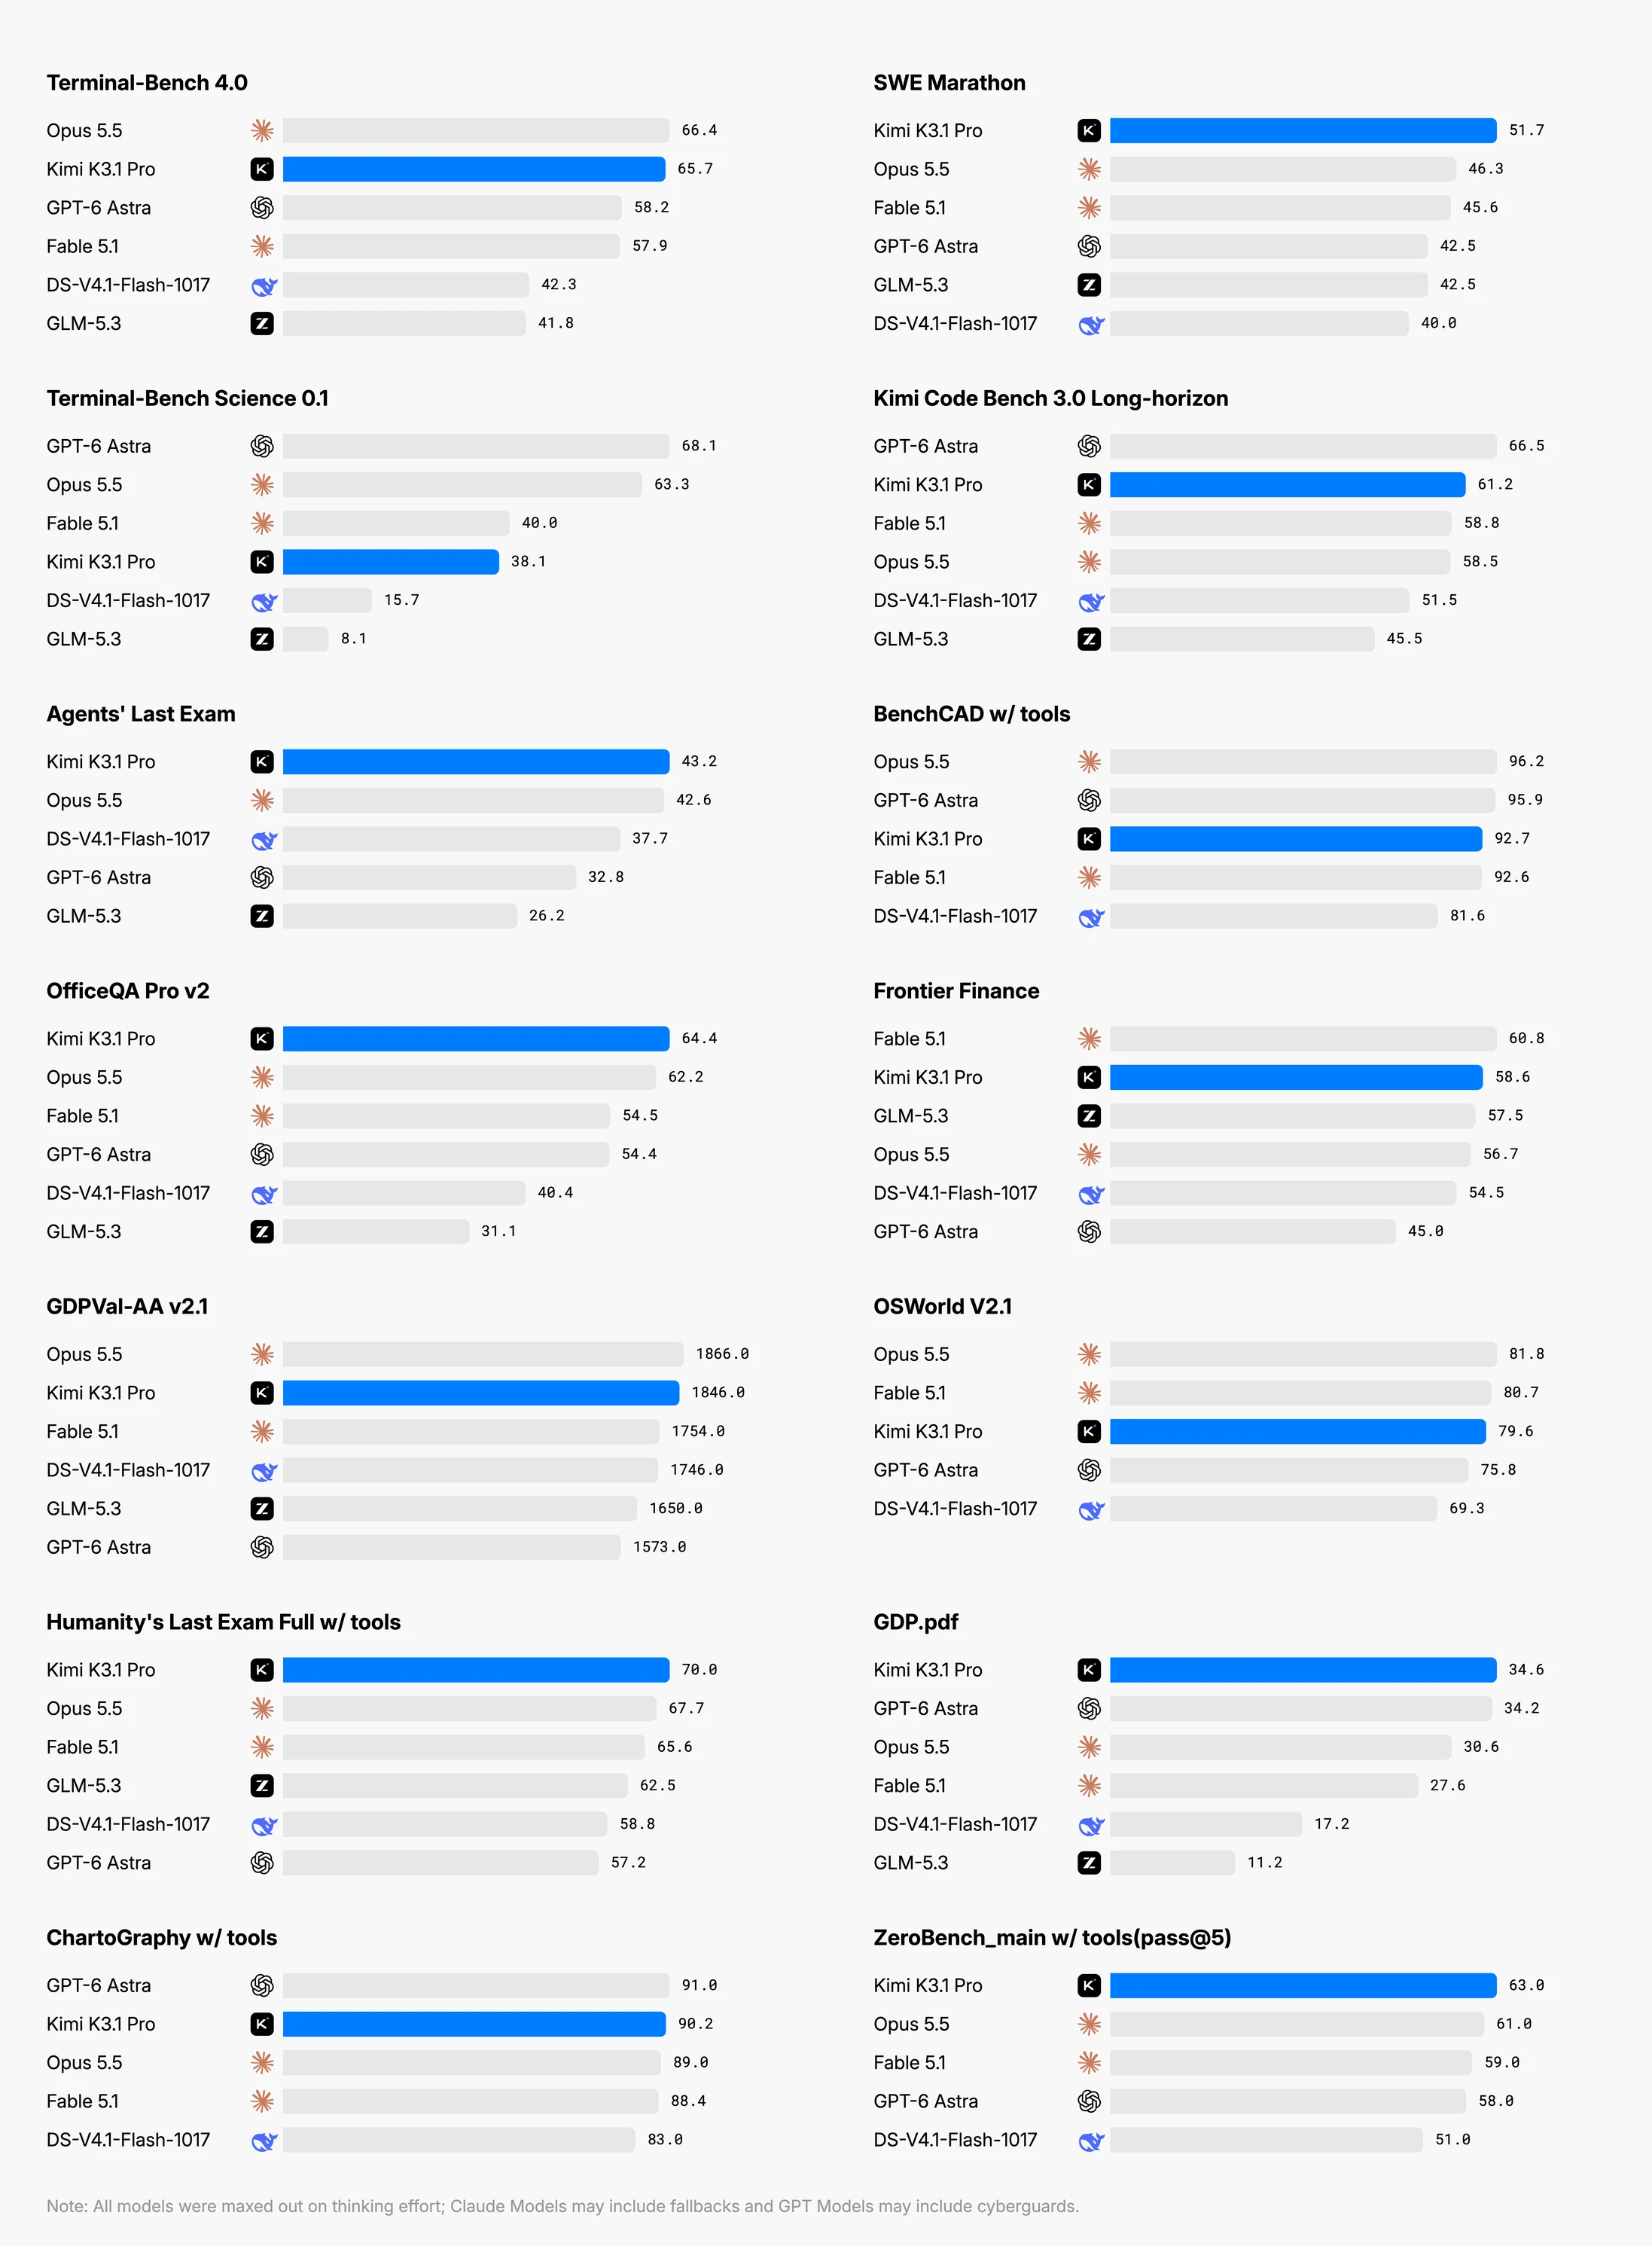
Kimiは、コーディング、3Dモデリング、金融、サイバーセキュリティを対象としたベンチマーク結果を公表した。Terminal-Bench 4.0 と BenchCAD(ツールあり)の結果は以下のとおりである。
| モデル | Terminal-Bench 4.0 | BenchCAD(ツールあり) |
|---|---|---|
| Kimi K3.1 Pro | 65.7% | 92.7% |
| GPT-6 Astra | 58.2% | 95.9% |
| Claude Opus 5.5 | 66.4% | 96.2% |
Terminal-Bench 4.0 では、K3.1 Pro が GPT-6 Astra を上回り、Claude Opus 5.5 にはわずかに及ばなかった。
その他の主な結果は以下のとおりである。
- Kimi Code Bench 3.0 Long-horizon で、K3.1 Pro は61.2%を記録し、K3 の55.95%を上回った。
- OfficeQA Pro v2 で、K3.1 Pro は64.4を記録し、最高水準の結果を示した。
- 金融領域では、K3 と比べて Financial Modeling が7.2ポイント、Financial Research が11.6ポイント向上した。
- Business Operation では、K3 の約4.2×の性能を示した。
Kimi Hallu Bench Hard における claim-level の幻覚率は、K3 の23.4%から K3.1 Pro の8.3%に低下したとされる。ただし、この数値は内部のストレステストベンチマークによるものであり、報告された数値は日常利用における全体的な誤り率を示すものではないと注記されている。
Kimiによると、Terminal-Bench 4.0 などの比較には独自モデルへのフォールバック挙動が含まれる可能性があり、これも制約として注記されている。
サイバーリスク低減の取り組み
オープンウェイト版の公開にあたり、Kimiは中間学習(mid-training)とRL学習の両段階から、サイバー関連データを特定して削除した。その一方で、モデルの有用性に必要な汎用のコーディングタスクは保持したと説明している。
xdev-bench-hard では、リスク低減策を施していないチェックポイントが pass@3 で90.5%の問題を解いた。最終版の K3.1 Pro は81.0%であった。
この記事は元記事の事実のみに基づいて自動生成されました。
筆者の見立て
- K3.1 Pro のサイバー能力は、設計上、パイプラインが生成しうる水準を下回っており、フロンティアの独自モデルに後れを取っていると解釈している。
- K3.1 Pro を非差別的な形で提供することは、防御目的で二重利用能力を必要とする人々の利益になると論じている。
- サイバー能力が段階的に広がることは、最終的にすべてのソフトウェアをより安全にすると予想している。
- オープンウェイトによって、多くのチームが自ら保守するコードを監査できるようになる可能性を示唆している。
出典
- 媒体名:Kimi
-