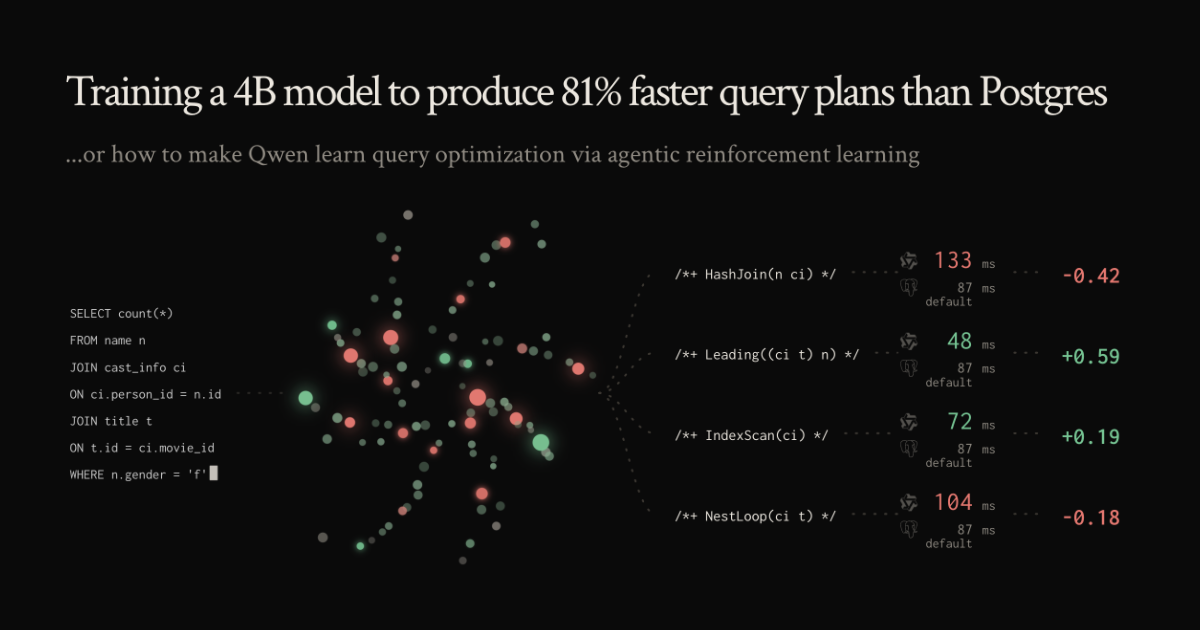
4Bパラメータのモデルで PostgreSQL の44.7%高速化を実現
4B パラメータの言語モデルが、教師あり微調整と強化学習で訓練され、PostgreSQL のクエリプラン最適化を大幅に改善した。Join Order Benchmark の113 件のクエリで44.7% のレイテンシ削減を達成した。
Rohan Bansal は、4B パラメータの言語モデルを post-training により PostgreSQL のクエリプラン生成に最適化させた。教師あり微調整(SFT)とエージェント型強化学習(RL)を活用した訓練の結果、Join Order Benchmark から抽出した113 件のクエリに対して44.7% のレイテンシ削減を実現した。モデルは初期段階では113 件中99 件のクエリに対してクエリプランを生成できなかった。
クエリ最適化の課題
クエリ最適化は長年の研究課題である。Leis et al. は2015年と2025年の二度にわたってクエリオプティマイザの性能について問い、10年の歳月を経ても「クエリオプティマイザは改善の余地が大きい」という結論に至った。クエリオプティマイザは完全なコスト最小化ではなく、多くの種類のクエリに対して十分な性能を目指すという設計思想を持つ。クエリプランの結合順序最適化は NP 困難な問題である。
PostgreSQL は複数のテーブル間の行の分布を把握できないため、均一分布を前提として最適化を行う。この仮定が失敗すると大きな性能低下につながる。Rohan Bansal は「PostgreSQL は自身のテーブルに関するすべてを知るはずなのに、実際には極めて困難である」と述べている。
訓練方法と使用モデル
モデルは empero-ai/Qwen3.8-4B-Distill をベースに開発された。post-training では教師あり微調整と agentic 強化学習を組み合わせた。エージェントには inspect_relation、get_column_stats、get_plan、evaluate_candidate、keep_default、finish の6つのツールが提供された。
ハードウェアには 2x H100 GPU ノード(vLLM とトレーナー用)および 2x RTX 3090 GPU rig(FLOPper 用)が使用された。FLOPper は16個の物理コア、64 GB の RAM、2 TB の NVMe SSD を備えている。訓練対象のデータセットは、IMDb データセット(ディスク上8.5 GB)を使用した。
ベンチマークと性能結果
Join Order Benchmark(JOB)は33 のテンプリート から構成される113 件のクエリで構成されている。また、Cardinality Estimation Benchmark(CEB)は16 のテンプレートと12 の一意な結合グラフトポロジーを持つ、約13,646 件の合成クエリで構成されている。
結合方法は hash join、merge join、nested-loop join の3種類が考慮された。スキャン方式は sequential、index、index-only、bitmap の4種類である。PostgreSQL は12以上の結合を持つクエリに対して、ダイナミックプログラミングと遺伝的アルゴリズムを使用して探索空間を削減する。
関連技術
pg_hint_plan は PostgreSQL の第三者製拡張で、構造化されたコメント形式のヒントを使用してクエリプラン選択に影響を与える。
この記事は元記事の事実のみに基づいて自動生成されました。
筆者の見立て
- 「言語モデルは出力が容易に検証可能なタスクの学習に特に長けている」と解釈している
- 「カーディナリティ推定の改善は、十年にわたる研究との対立を招くため、取り組む価値がない」との結論に至ったと論じている
- 「正しいアプローチは、一度限りのクエリで PostgreSQL に勝つことではなく、繰り返し実行されるクエリで勝つ可能性がある」と予想している
- 「重い分析ワークロードという特定のデータベース利用パターンこそが、言語モデルに適した条件である」と考えている
出典
Rohan Bansal「Training a 4B model to produce 81% faster query plans than Postgres」https://rohanbansal.com/qorl (「Flow-loss: Learning Cardinality Estimates That Matter」の報道による)